
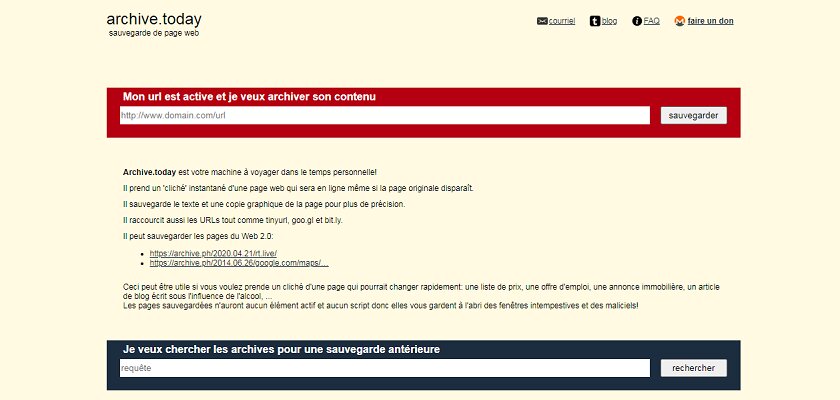

Archive.today est un service gratuit qui permet de sauvegarder une copie d’une page web telle qu’elle s’affiche à un moment précis. Une fois la capture faite, elle reste consultable à une adresse fixe même si la page d’origine est modifiée ou supprimée. Le service existe depuis 2012 et il est très utilisé par les journalistes, les chercheurs et les contributeurs de Wikipedia.
Depuis début 2026, il fait aussi parler de lui pour de mauvaises raisons. Wikipedia a décidé de retirer tous les liens vers ce site, après des soupçons d’attaques informatiques et de captures modifiées.
Voici comment fonctionne l’outil, ce qu’il sait faire, ses limites et les alternatives à connaître.
Qu’est-ce qu’Archive.today ?
Archive.today est un service d’archivage web à la demande. Contrairement à un robot qui parcourt Internet en continu, il enregistre uniquement les pages que les utilisateurs lui demandent de sauvegarder. Chaque capture reçoit une adresse courte du type archive.today/XXXXX, que l’on peut partager ou conserver comme preuve.
Le service est accessible via plusieurs noms de domaine (archive.today, archive.is, archive.ph, archive.md, entre autres). Il n’a aucun lien avec Internet Archive, l’organisation américaine à but non lucratif qui gère la Wayback Machine, même si les deux outils jouent un rôle proche. Wikipedia a d’ailleurs pris soin de le préciser pour éviter toute confusion.
Archive.today n’a pas de fonctionnalité payante et se présente comme financé de manière privée. Un lien vers un portail de dons figure sur la page d’accueil.
Lire Aussi : Comment utiliser la Wayback Machine pour retrouver d’anciennes pages web
Ce que le service enregistre
Lors d’une capture, Archive.today conserve plusieurs éléments.
- Le texte de la page.
- Les images.
- Le contenu des cadres (frames).
- Le contenu chargé ou généré par JavaScript, ce qui est utile pour les sites modernes.
- Une capture d’écran de 1024 x 768 pixels.
La copie est consultable comme une vraie page, avec ses liens internes, et en parallèle sous forme d’image. Cette double sauvegarde permet de retrouver l’aspect exact de la page, même quand son code est complexe.
Certains éléments restent hors de portée. Les PDF, les fichiers Flash, les vidéos et les sons ne sont pas conservés. Les flux RSS et autres pages XML sont également mal archivés (parfois enregistrés comme des pages blanches). Sur une page de YouTube, par exemple, seuls le titre de la vidéo et les commentaires sont sauvegardés, pas la vidéo elle-même. Les éléments qui dépendent du serveur, comme les formulaires, les zones de recherche ou les commentaires, apparaissent figés.
Comment archiver une page avec Archive.today ?

Le site ne demande aucune inscription pour archiver une page, et la méthode est assez simple :
- Copiez l’adresse (URL) de la page à sauvegarder
- Ouvrez le site d’Archive.today et collez l’adresse dans le premier champ, puis lancez la sauvegarde
- Patientez pendant la capture (Elle dure en général quelques secondes à quelques minutes)
- Récupérez l’adresse courte de l’archive pour la conserver ou la partager
Des extensions existent pour Chrome, Firefox et Edge. Elles permettent d’archiver la page affichée en un clic. Des bookmarklets et des outils pour Android permettent aussi la sauvegarde depuis un smartphone.
Lire Aussi : Comment savoir si une capture d’écran a été modifiée
Comment retrouver une archive existante ?

Le second champ de la page d’accueil sert à chercher des captures déjà réalisées. Vous pouvez saisir une adresse complète, un nom de domaine, ou utiliser des opérateurs de recherche.
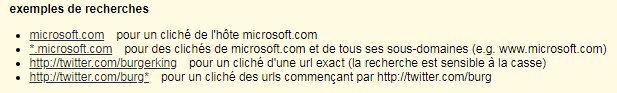
Les adresses peuvent aussi être construites à la main, ce qui est pratique pour les liens dans un article.
| Objectif | Format d’adresse |
| Voir toutes les captures d’une page | archive.today/https://exemple.fr/page |
| Voir la dernière capture | archive.today/newest/https://exemple.fr/page |
| Voir la première capture | archive.today/oldest/https://exemple.fr/page |
| Choisir une période | archive.today/2025/https://exemple.fr/page (année), 202501 (mois), 20250115 (jour) |
| Voir tout un domaine | archive.today/exemple.fr |
La date peut être précisée jusqu’à la seconde. Pour pointer un passage dans une longue page, il est possible d’ajouter à l’adresse une position de défilement (par exemple #40%) ou un identifiant de sélection de texte obtenu en surlignant la phrase voulue.
Le service est compatible avec l’API Memento, un protocole qui facilite l’échange avec d’autres services d’archivage. Les anciennes archives peuvent aussi être téléchargées au format ZIP pour un stockage local.
Paywalls et robots.txt, ce qu’il faut savoir
Archive.today ne respecte pas le fichier robots.txt, qui sert aux sites à indiquer ce que les robots ont le droit de visiter. Son opérateur justifie ce choix par le fait que le service n’est pas un robot qui parcourt le web. Il enregistre une seule page à la demande d’un utilisateur, comme le font les services de capture d’écran. C’est ce qui permet de sauvegarder des pages que d’autres archiveurs ne peuvent pas toucher.
C’est aussi la raison pour laquelle l’outil est connu pour contourner certains paywalls. Mais en pratique, il vaut mieux ne pas compter dessus pour conserver un article réservé aux abonnés ou une publication de réseau social privée.
Lire Aussi : Bitchat, la messagerie Bluetooth de Jack Dorsey qui fonctionne sans Internet
Pourquoi Wikipedia a banni Archive.today ?
En février 2026, la communauté de Wikipedia a décidé de bloquer les nouveaux liens vers Archive.today et de supprimer ou remplacer les anciens. Cela concerne près de 700 000 liens répartis sur environ 400 000 pages.
Deux problèmes ont motivé ce choix.
Le premier concerne une attaque par déni de service distribué (DDoS). Le blog Gyrovague, tenu par Jani Patokallio, avait publié en 2023 une enquête sur l’identité du responsable du service. Après le refus de l’auteur de retirer son texte, le blog a subi des attaques. Un code malveillant aurait été placé dans la page CAPTCHA d’Archive.today et redirigeait les visiteurs vers le blog, ce qui provoquait la surcharge. Pour Wikipedia, c’est un problème de sécurité, car des lecteurs peuvent être utilisés à leur insu pour attaquer un site.
Le second problème touche à la fiabilité des archives. Des contributeurs ont constaté que certaines captures avaient été modifiées, avec par exemple le nom de Jani Patokallio ajouté à des endroits où il n’apparaissait pas à l’origine. Un service d’archivage ne vaut que par la fidélité de ses copies. Si une capture peut être changée après coup, elle ne prouve plus rien.
Le service fait aussi l’objet d’une enquête du FBI depuis la fin 2025, qui cherche à identifier son opérateur.
Ce qu’il faut savoir avant de l’utiliser
Au-delà de la polémique, l’outil a des limites techniques qu’il faut connaitre :
- Formats non pris en charge : PDF, Flash, audio et la plupart des vidéos ne sont pas sauvegardés. Si la preuve se trouve dans l’un de ces formats, il faut en garder une copie à part.
- Contenus protégés : Les pages derrière un identifiant ou un blocage géographique ne sont généralement pas bien capturées.
- Disponibilité : Les surcharges, les protections contre les attaques et les problèmes de DNS ou de Cloudflare peuvent ralentir ou faire échouer une capture.
- Archives quasi définitives : Le service ignore robots.txt et supprime rarement des pages, sauf cas de DMCA ou d’abus. Une page qui contient des données personnelles peut donc rester en ligne longtemps. La FAQ précise aussi que les pages contraires aux règles de l’hébergeur ou totalement vides peuvent être effacées.
- Opérateur anonyme : Le service est géré par une personne anonyme sans institution derrière lui. Sa pérennité n’est donc pas garantie.
- Confidentialité : Votre adresse IP n’est pas divulguée aux lecteurs de l’archive, mais lors d’une capture, elle est transmise au site archivé dans l’en-tête X-Forwarded-For, comme avec un proxy. Cela permet au site d’adapter son contenu à votre région.
Lire Aussi : Comment naviguer sur le dark web en toute légalité
Quelles alternatives à Archive.today ?
Pour une preuve importante, Il vaut mieux multiplier les sauvegardes avec plusieurs services comme :
- Wayback Machine (Internet Archive) : C’est la référence, gérée par une organisation à but non lucratif. Elle respecte les règles d’exclusion des sites, ce qui limite certaines captures, mais son cadre institutionnel est plus rassurant.
- Fichier WARC en local : Ce format standard d’archivage web permet de conserver une copie sur votre propre disque, sans dépendre d’un tiers.
- Perma.cc : Ce service, développé dans un cadre universitaire, est conçu pour les citations et les références juridiques ou académiques. Il propose un usage gratuit limité et des offres payantes.
Pour les enquêtes sensibles, il est conseillé de doubler la sauvegarde avec la Wayback Machine ou un WARC local.
Archive.today reste pratique pour une consultation rapide, par exemple pour lire une page qui a disparu ou pour garder une trace d’un contenu avant sa modification. Mais pour une preuve, une source citée dans un article ou un dossier sensible, la prudence s’impose. Les soupçons de modification de captures, le manque de transparence de l’opérateur et l’enquête en cours justifient de ne pas en faire la seule copie.
FAQ
Archive.today est-il gratuit ?
Oui, aucune fonctionnalité payante n’existe.
Faut-il un compte pour archiver une page ?
Non. Il n’y a pas de compte, donc pas de gestion de favoris intégrée. Vous pouvez conserver vos liens dans un gestionnaire de favoris classique.
Archive.today est-il la même chose qu’Archive.org ?
Non. Ce sont deux services distincts, sans lien entre eux.
Combien de temps une page reste-t-elle archivée ?
La FAQ parle de conservation quasi illimitée. Seules les pages contraires aux règles de l’hébergeur ou entièrement vides peuvent être supprimées.
Peut-on archiver un PDF ou une vidéo ?
Non, ces formats ne sont pas pris en charge.
Peut-on demander la suppression d’une page archivée ?
Le service précise qu’il n’est pas une source d’information faisant autorité et qu’il certifie seulement qu’une page existait à un moment donné. Les suppressions restent rares, hors DMCA ou abus.